数据与政企项目潮汕话与粤语文本互译规则编制分层抽检
潮汕话与粤语语音及文本标注数据集
音译转写与潮普互译,数万条验收交付
- 客户类型
- 外部 AI 数据公司
- 项目周期
- 2024.12 – 2026.09
- 我方角色
- 规则编制 · 质检体系 · 项目交付
285 个
业务文件
2000 行
单文件互译文本
数万条
语音与双语标注
Problem · 客户痛点
- 潮汕话与粤语都有大量「有音无字」的口语词,不同标注员写出来的本字不一样,同一批数据内部就先打架。
- 外地方言标注团队听不懂本地口音,遇到杂音、气声、多人对话只能凭感觉猜,错误率高且难以复核。
- 数据公司按准确率验收,返工一次成本极高,必须有可执行的规则与可量化的质检,而不是靠人盯人。
Solution · 解决方案
01
先编规则,再开工
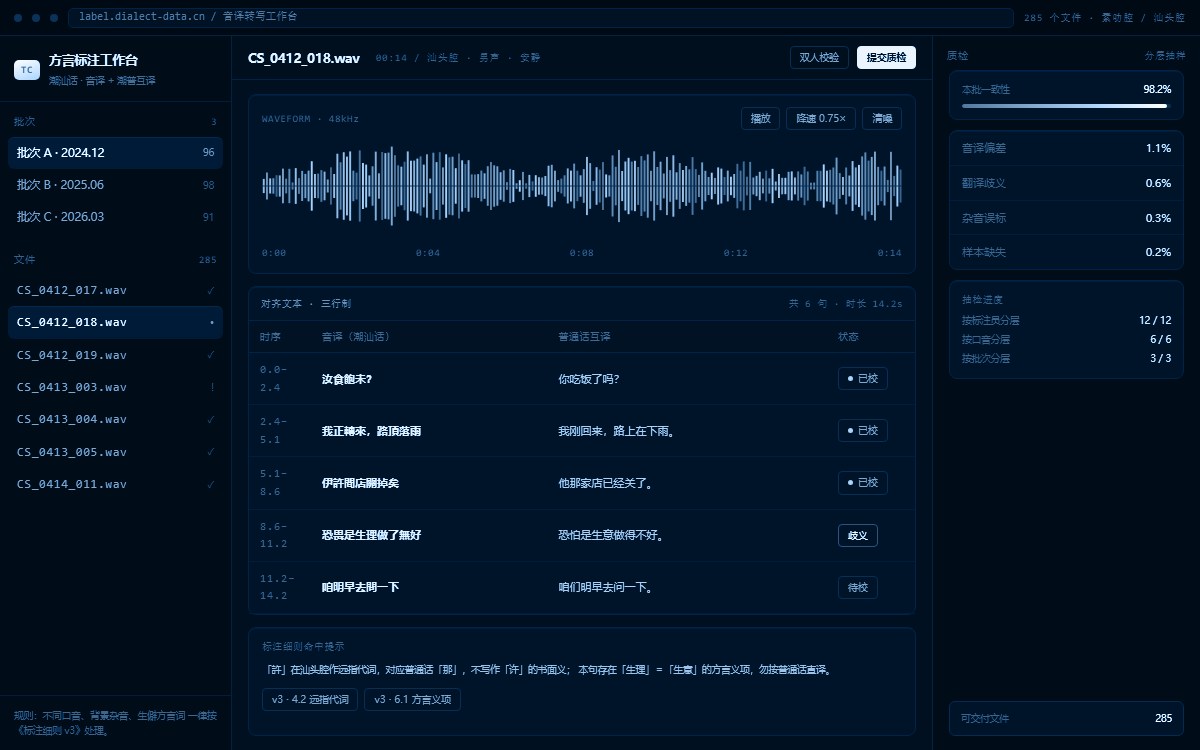
结合潮汕话正字表与本地口语习惯编制完整标注细则与校对规范,逐条明确口音差异、背景杂音、生僻方言词、歧义语句的处理准则,同一套细则同时适用于粤语语料,让不同标注员产出可比对的结果。
02
岗前培训 + 试标校准
任务拆分分配后组织规则培训交底,先小批量试标并统一分歧点,达成一致性后再放开产能,避免大规模返工。
03
分层抽样质检 + 问题复盘
执行分层抽样质检机制,按标注员、口音类型、文件批次分层抽检;定期复盘错误案例,处理音译偏差、翻译歧义、样本缺失等异常;音译与翻译做双重校验,保证读音、文字、语义三者一致。
Features · 功能模块
系统里具体有哪些功能、各自解决什么问题——验收时按这份清单逐项核对。
01
标注细则编制
结合潮汕话正字表与本地口语习惯,逐条写清口音差异、背景杂音、生僻方言词、歧义语句的处理准则。
02
音译转写
潮汕话与粤语语音转写为规范本字,处理「有音无字」的口语词,统一书写口径。
03
双向互译标注
方言与普通话双向互译,句式与用词口径统一,不同标注员产出可比对。
04
双重校验
音译与翻译交叉核对,保证读音、文字、语义三者一致。
05
岗前培训与试标校准
任务分配后组织规则培训交底,先小批量试标统一分歧点,再放开产能。
06
分层抽样质检
按标注员、口音类型、文件批次分层抽检,实时统计准确率,问题批次即时返修。
07
问题复盘与交付
错误案例定期复盘并固化进细则,按批次交付数据集与质检报告。
Results · 交付成果
- 完成 285 个业务文件(单文件 2000 行潮-普互译文本)及数万条语音与双语标注数据的验收交付。
- 搭建「规则编制 → 人员培训 → 过程质检 → 问题复盘」完整作业流程,可直接复制到粤语与其他方言语料。
- 优化音译、翻译双重校验机制,方言数据集的读音、文字、语义一致性得到结构化保障。
Next Step · 下一步
先评估可行性,再谈合作
不需要完整需求文档,说明现有业务流程或算力 / 数据需求即可获得初步判断与方案建议。
工作日 24 小时内回复
微信扫码
扫码添加,注明来意
WeChat / 微汕网络